模型更便宜、基礎設施更昂貴:AI 正把參與資格改寫成成本與證據
模型更強、算力資本更重、學生先付 Token,連衛星都開始替污染源留下可追溯的證據。
模型能力正在變得更容易取得,但真正稀缺的東西沒有消失,只是換了位置:有人要付更高的推理費,有人先替資料中心承擔資本承諾,有人得自己購買課堂所需的 Token,也有人開始用衛星資料把原本模糊的責任定位到具體排放源。這四條主線放在一起看,問題已經不是「模型能不能做」,而是誰能負擔、誰能驗證,以及結果能否被追責。
Fable 5.1 變便宜了,但最強能力仍然要付費
Anthropic 在 9 月 1 日發布Claude Fable 5.1 與 Mythos 5.1 的官方說明:兩者是同一個模型,但保護層級不同;Fable 5.1 一般可用,Mythos 5.1 則透過可信存取計畫,提供給需要更寬鬆資安與生物研究限制的特定組織。官方比較表中,Fable 5.1 在 Terminal-Bench-Science 0.1 得分 52.6%,前代 Fable 5 為 24.7%;Terminal-Bench 4.0 則列出 Fable 5.1 為 55.8%、Mythos 5.1 為 60.9%。這些數字來自不同測試設定,不能壓成一張單一總排名,但足以說明它把長時間、工具密集的工作推得更遠。
價格調整反而更能看出產品策略。Fable 5.1 的定價與可用性頁顯示,Cache Read 降到每百萬 Token 0.25 美元,比 Fable 5 低 75%;Anthropic 估計典型工作負載成本約降 25%,高度代理化的工作最多可降約 45%,一般輸入與輸出 Token 的每百萬 10/50 美元則維持不變。官方發布說明也提到,資安防護對良性請求的誤判減少,現在允許用 Fable 5.1 尋找軟體漏洞,但不允許用它開發漏洞利用程式;同時,Anthropic 的 Preserved thinking 平台文件說明,對 2026 年 8 月 31 日 00:00 UTC 之後建立的新帳戶,新的對話歷史限制會在修改先前 system prompt、tools 或訊息時拒絕請求或丟棄受影響的 thinking block,讓能力提取與內容追蹤都變成產品設計的一部分。
這代表「最強模型」的競爭已經不只在跑分。企業還要一起購買可接受的資料保留條件、足夠低的長任務成本、可用的安全例外,以及不會被輕易蒸餾的上下文。能力越高,使用它的制度門檻也越具體。
🛎️ 要點:模型可以更強、單位成本可以下降,但真正的產品仍是能力、權限、資料與價格的整體組合。
一棟還沒完成的資料中心,先成為資本市場文件
SB Energy 在 9 月 1 日提交 S-1。這件事本身由美國證券交易委員會的申報紀錄確認;但「提交上市文件」不等於資料中心已經營運,也不等於未來收入已經實現。要理解它的結構,更可靠的入口是公司文件與合作方的正式揭露,而不是一句聳動的估值敘事。
NVIDIA 第二季財務文件寫得更直接:NVIDIA 在 2026 年 8 月為 SB Energy 位於俄亥俄州的 PORTS-Pike 園區提供土地、電力與機房外殼建置的信用支持,園區約 4.25 GW,預計由 OpenAI 以 20 年租約承租;保證義務上限為 1050 億美元,第一批資料中心預計在 NVIDIA 財年 2029 年可提供服務。文件還說,每一代 NVIDIA 基礎設施可能對應約 150 萬張 GPU,並帶來 1500 億至 2000 億美元的 NVIDIA 收入,但這些都是附帶條件的長期預期,不是已經完成的銷售。
因此,這個案例的重點不是「一棟不存在的樓也能上市」這句嘲諷,而是資本市場開始把客戶、電力、租約、晶片、保證與未來產能包成同一份 AI 基礎設施承諾。當需求尚未轉成穩定現金流時,誰的資產負債表替誰先墊付風險,會比宣稱模型多聰明更值得追蹤。
🛎️ 要點:AI 基礎設施的「產品」還沒交付以前,融資條件與違約風險已經先成為產品的一部分。
當 Token 成為課堂耗材,教育也在重新定義會做
一篇由智源社群轉載、並標示來源為量子位的南京大學課堂報導,記錄計算機學院副教授蔣炎岩在《生成式軟體工程》課程中提出的激烈觀點:沒有付費 Token 的學生,可能根本沒有進入這門課所要求的實作環境。報導描述的課程規則包括禁止「古法編程」、Token 自費,但不鼓勵無限制燒 Token;課堂也推薦使用 DeepSeek V4 Flash,並建議先以約 100 元人民幣支應練習費用。
這門課真正想教的,不是誰能把額度花光,而是如何拆任務、挑模型、控制成本、檢查結果。當模型已能代寫大量程式,學生需要練習的就從「把每一行打出來」轉向「知道要讓系統做什麼、如何驗收,以及錯了要怎麼修」。這也是為什麼 Token 會被比喻成實驗耗材:它讓抽象的 API 使用變成有成本的工程決策。
問題在於,若付費 Token 變成學習的先決條件,家庭資源就會直接轉化為學習優勢。學校若只要求學生自費,等於把基礎設施成本外包給個人;比較公平的做法應是提供共享額度、沙盒與可觀測的使用紀錄,再把評分放在問題拆解、驗證與成果,而不是誰的帳戶餘額更高。
🛎️ 要點:AI 時代需要的是能管理模型的人,但「能不能付費使用模型」不該先決定誰有資格學會管理。
當衛星能替排放源定位,氣候治理從爭論變成資料
Google Research 與 NASA 噴射推進實驗室合作的 MAPL-EMIT,將衛星的高光譜資料、深度學習與物理模擬接在一起。Google Research 的 MAPL-EMIT 說明指出,團隊把 360 萬個合成甲烷羽流注入真實 EMIT 影像,模型在專家標註羽流上達到 84% recall,在約 1100 個 EMIT granules 中找出約多 50% 的可能羽流,並成功涵蓋全球 25 個最大排放掩埋場中的 24 個。研究同時開放資料庫、訓練模型、合成羽流資料與推論函式庫;相關研究也已發表於《PNAS》的論文。
這項技術的價值不只是「看見更多」。MAPL-EMIT 會同時估算羽流強度、分割重疊羽流的邊界,再把氣體回溯到可能的來源;但 Google 也明確提醒,高靈敏度模型仍會產生誤判,因此輸出要附帶信心分數,讓使用者在抓漏能力與誤報風險之間做取捨。這種限制很重要:被衛星標出的來源是需要調查的證據,不是可以跳過程序的定罪。
全球甲烷承諾將甲烷減量設定為相較 2020 年排放量,在 2030 年至少降低 30% 的集體目標,而自動化追蹤讓「是不是我的排放」不再只能靠各方說法。當定位、時間序列與公開資料可以被不同研究者重算,氣候治理才有機會從責任爭議走向改善與稽核。
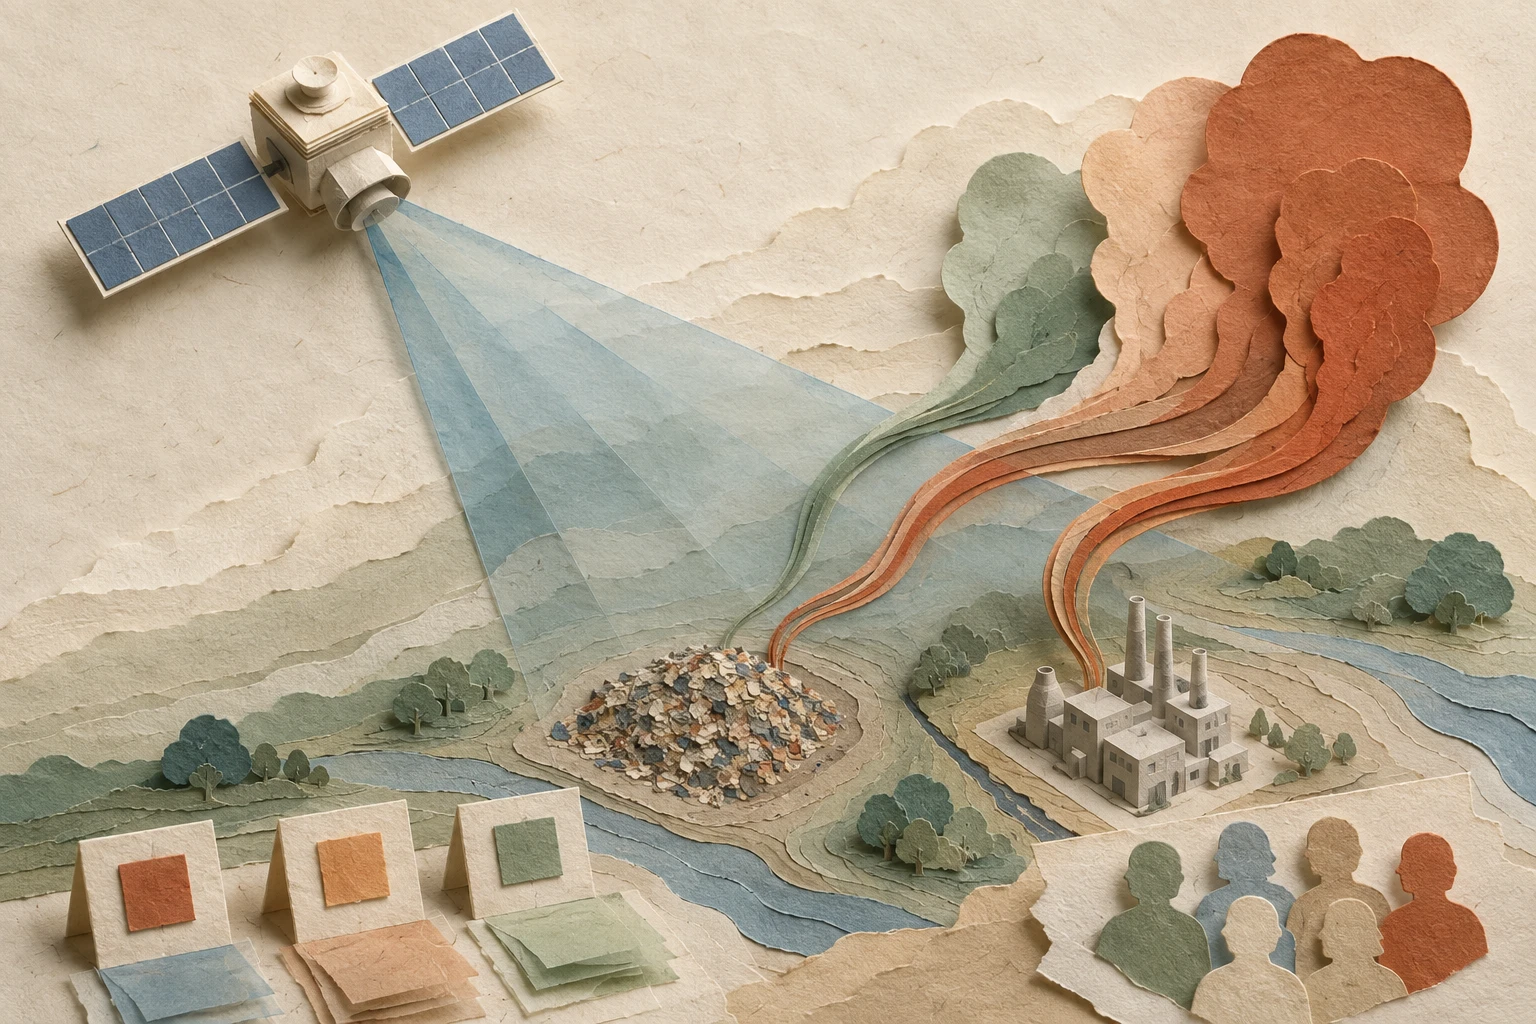
🛎️ 要點:AI 最有公共價值的時刻,不是替人下結論,而是把原本看不清的責任線索變成可重算、可追蹤的證據。
八則短訊,把入口、資料與執行權推向同一條線
- Google Pics 官方介紹顯示,Google 推出以提示詞為入口的影像創作與編輯工具,正於數週內逐步開放給 AI Pro、Ultra 與多數 Workspace 商務客戶,進一步進入 Canva 原本佔據的設計工作流。
- 《洛杉磯時報》的報導指出,Google 已接觸 Disney、Universal 與 Warner Bros. Discovery,討論授權角色與電影資料庫給 AI 工具使用;目前尚未達成協議,法律、工會與版權問題仍是阻力。
- OpenAI 的 Epic 整合說明表示,ChatGPT for Healthcare 可在獲授權的組織環境中讀取 Epic 的病人脈絡,讓醫療團隊整理病史與變化;這是受權限控制的唯讀流程,不是直接改寫病歷。
- Perplexity 的 Hybrid Compute 發布文介紹把敏感檔案與裝置操作留在 Mac 本機,把需要前沿推理、網路搜尋與規劃的部分交給雲端,並以本機隱私閘門決定哪些內容可離開裝置。
- Meta 的 Muse Voice Transcribe 介紹說明,新模型支援即時串流語音辨識、20 名以上說話者分離、斷句,以及 25 種以上語言與自然切換語言。
- The Information 的報導稱,Meta AI 主管 Alexandr Wang 告知員工,公司將把內部通訊從 Google Chat 移往 Slack,理由之一是 Slack 更適合代理工作流程;這是內部管理選擇,不等於所有企業都應採用同一工具。
- Runway 對 Solaris 的研究說明把它稱為 Interface World Model:系統不是先產生固定畫面再交給程式執行,而是隨使用者點擊、拖曳與輸入,逐幀生成可互動介面。
- World Labs 對 Atlas 的介紹顯示,Atlas 原生處理文字、圖片、影片與 3D,能從少量影像與相機資訊重建空間,也能生成新視角與 3D 輸出,讓世界模型更接近可模擬的空間工具。
這些短訊和四條主線共同指向同一個轉折:AI 正把入口、資料、基礎設施與執行權重新綁在一起。模型變便宜不代表參與變得平等,模型變強也不代表結果自然可靠;真正需要被建設的,是誰付費、誰授權、誰看得到、誰能重算,以及錯誤發生時誰有權停止它。