數學研究與訓練效率:AI 規模競賽回到系統設計
費爾茲獎得主加入 OpenAI 安全研究,BigMac 的多模態排程則檢驗算力效率能否跟上模型規模。
數學獎得主加入 OpenAI,安全工作接上數學研究
Quanta 報導指出,Jacob Tsimerman 因 André–Oort 猜想相關研究,成為 2026 年四位費爾茲獎得主之一。Mark Chen 的公開貼文歡迎 Tsimerman 加入 OpenAI,並提到他對 AI 安全工作的投入。
Quanta 摘錄提到,Tsimerman 看到一種人類可能難以勝過的新型解題者。這反映他對 AI 數學能力快速進展的疑慮,不代表他預測了確定的時間表或結果。
從公關角度看,這次聘任的影響可能不只在於多了一位安全研究者:在快速商業化之際,費爾茲獎得主加入,能讓 OpenAI 向投資人、監管者與客戶展示公司重視安全研究。OpenAI 並未獲得費爾茲獎,卻能借用其聲望;這也形成一個反差——一位對 AI 數學能力提出疑慮的數學家,成了這家加速 AI 技術發展的公司用來塑造信任形象的標誌。這是對聘任宣傳效果的評論,不是安全表現的獨立證明。
BigMac 把多模態訓練的等待問題轉為排程問題
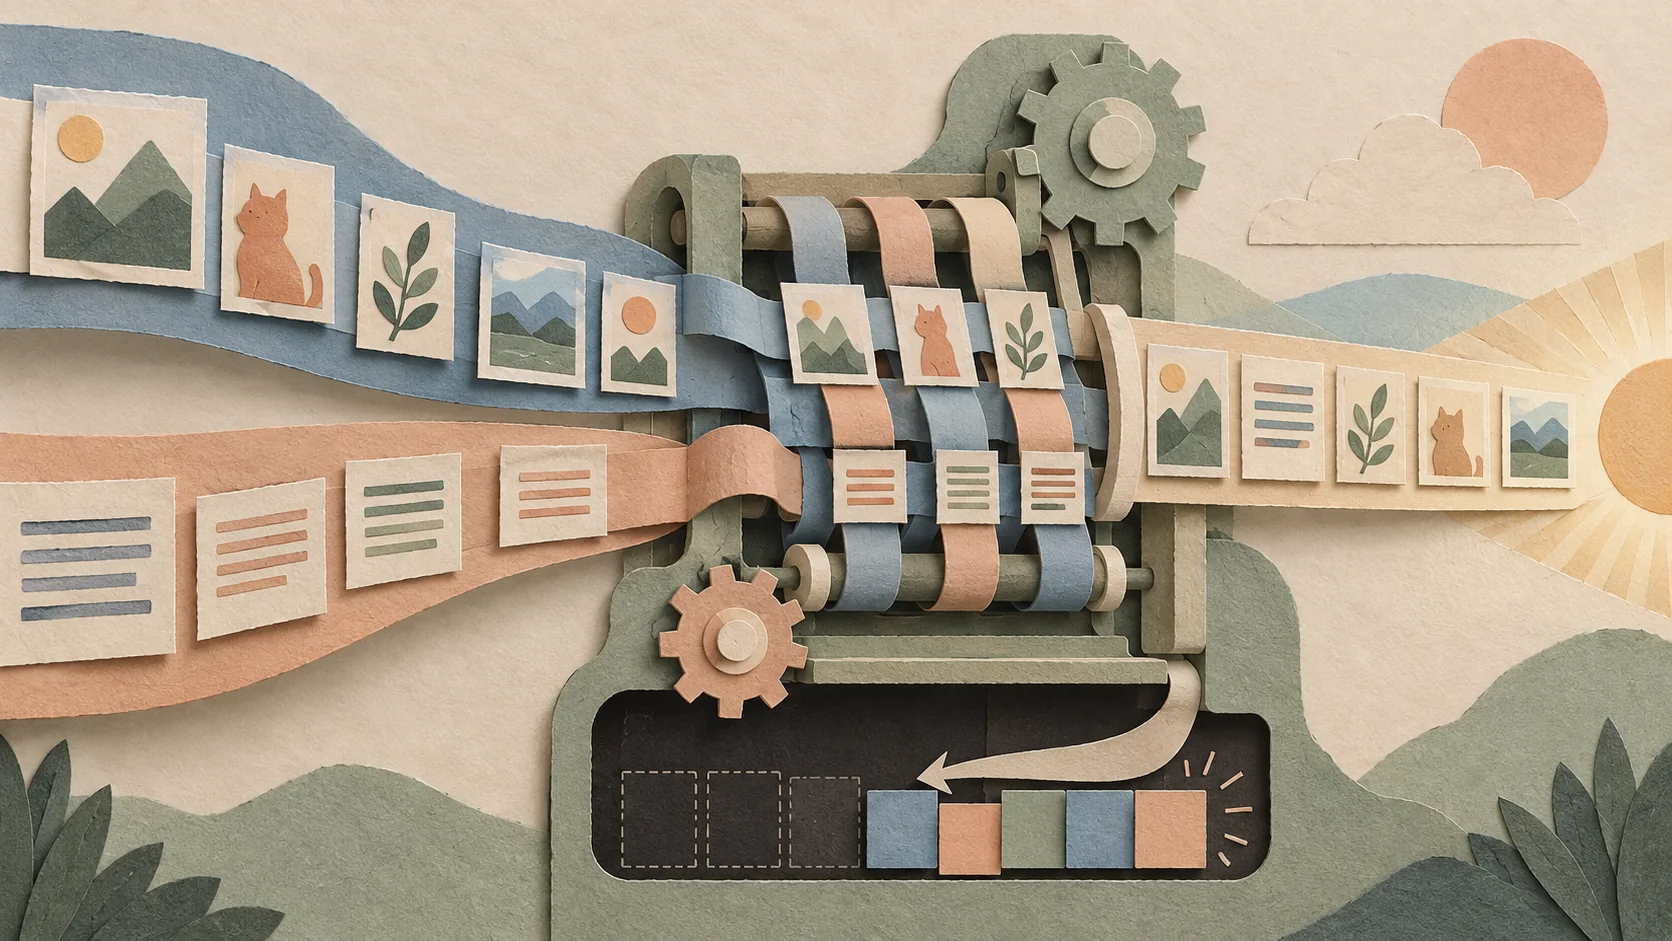
由小紅書研究人員參與的 Dots Infra 團隊在官方 GitHub 專案公開 BigMac 程式碼;論文也列出作者所屬的研究機構。這套訓練方法會把影像等模態的編碼器與生成器運算嵌入原有的大型語言模型流水線。不同元件的執行時間與記憶體需求不一,分開運算容易留下等待空檔,提前計算又會累積供反向傳播使用的 activation。
在 Qwen3-30B-A3B 的 MLLM-Understanding 工作負載中,論文報告 BigMac 的迭代速度約為 Optimus 的 1.08 至 1.1 倍、Megatron-DistTrain 的 1.6 至 1.9 倍。兩個區間對應不同設計基準,不能合併成同一個加速幅度。論文也指出,BigMac 的記憶體用量在批次增大時保持穩定;這些是作者選定環境中的結果,不能直接套用到所有訓練叢集。
BigMac 瞄準 GPU 閒置和 activation 儲存造成的基礎設施浪費。若它能在商用訓練堆疊重現論文效果,同一個叢集可能訓練更大型的多模態模型、承接更多工作,並降低每個生成 token 背後的基建成本。這仍是有條件的推論;論文沒有測量商用 token 價格,也沒有證明成本已按倍數下降。BigMac 的價值不在於已經讓智慧變便宜,而在於提供改善硬體利用率的可檢驗排程方法。